مسمومسازی داده چیست و چگونه آموزش مدل هوش مصنوعی را مختل میکند؛ راهنمای کامل و کاربردی
در دنیای امروزی که دادهها به عنوان «نفت جدید» شناخته میشوند، امنیت و کیفیت این دادهها به همان اندازه اهمیت دارند که خود دادهها. یکی از تهدیدهای جدی که در سالهای اخیر به شدت مورد توجه قرار گرفته، مسمومسازی دادهها است. این روش مخرب، که به انگلیسی با اصطلاح Data Poisoning شناخته میشود، به معنای آلودگی عمدی یا تصادفی مجموعه دادههای آموزشی مدلهای هوش مصنوعی است تا عملکرد آنها را مختل کند یا حتی بهطور کامل بیاعتبار سازد. اما چگونه این اتفاق میافتد؟ چه اثراتی بر مدلهای هوش مصنوعی دارد؟ و چگونه میتوان از آن جلوگیری کرد؟ در این راهنما کامل، به بررسی این موضوع از همه جوانب میپردازیم.
مسمومسازی دادهها چیست؟
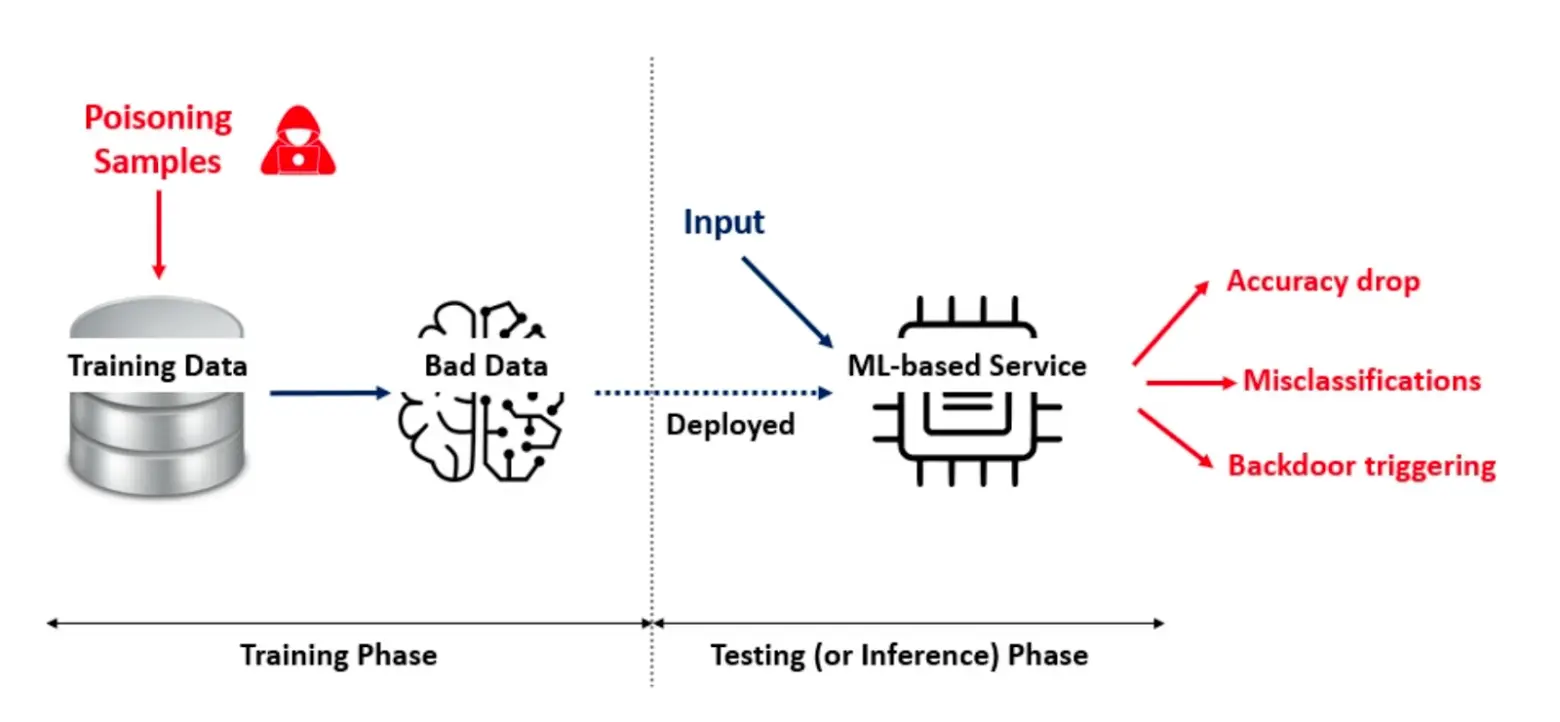
مسمومسازی دادهها یک تکنیک سایبری است که در آن مهاجم یا فردی با نیت مخرب، دادههای آموزشی مدلهای یادگیری ماشین را با دادههای نادرست، نویز، یا اطلاعات دروغین آلوده میکند. این آلودگی میتواند به صورت مستقیم (با تغییر دادههای موجود) یا غیرمستقیم (با افزودن دادههای نادرست) انجام شود. هدف اصلی این کار، تغییر رفتار مدل هوش مصنوعی به نفع مهاجم یا به زیان کاربر نهایی است.
به عنوان مثال، تصور کنید یک مدل تشخیص چهره برای یک سیستم امنیتی آموزش دیده است. اگر مهاجم دادههای نادرستی از چهرههای افراد غیرمجاز را به مجموعه آموزشی اضافه کند، مدل ممکن است در تشخیص صحیح چهرهها دچار اشتباه شود و در نتیجه سیستم امنیتی ناکارآمد شود.
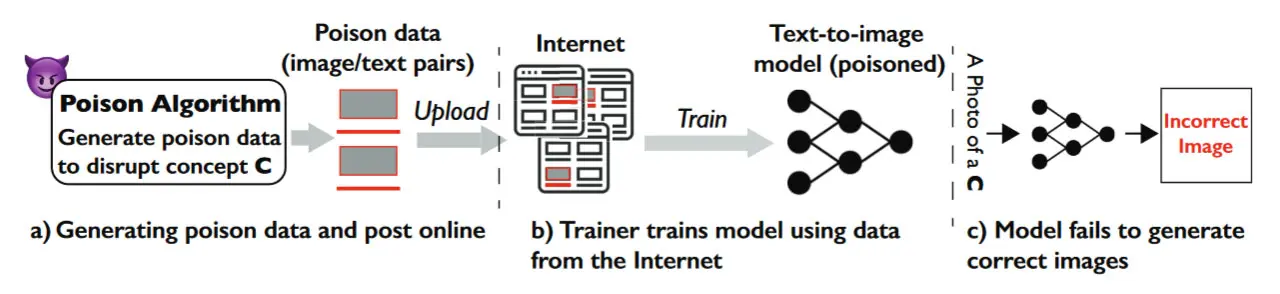
چگونه مسمومسازی دادهها آموزش مدلهای هوش مصنوعی را مختل میکند؟
مسمومسازی دادهها میتواند به روشهای مختلفی آموزش مدلهای هوش مصنوعی را مختل کند. برخی از این روشها عبارتند از:
- افزودن دادههای نادرست: مهاجم دادههای دروغین یا نادرست را به مجموعه آموزشی اضافه میکند تا مدل به اشتباهات خاصی دچار شود. برای مثال، در یک مدل تشخیص سرطان، اگر دادههای نادرستی از نمونههای سالم به عنوان «سرطانی» اضافه شود، مدل ممکن است در تشخیص صحیح سرطان دچار مشکل شود.
- تغییر برچسبهای دادهها: در این روش، برچسبهای دادههای موجود در مجموعه آموزشی تغییر مییابد. به عنوان مثال، در یک مدل تشخیص تصاویر، برچسب یک تصویر از «گربه» به «سگ» تغییر مییابد. این کار باعث میشود مدل در تشخیص صحیح تصاویر دچار اشتباه شود.
- افزودن نویز: مهاجم دادههای نویز یا غیرمفید را به مجموعه آموزشی اضافه میکند تا مدل نتواند الگوی صحیح را تشخیص دهد. این روش میتواند باعث کاهش دقت مدل شود.
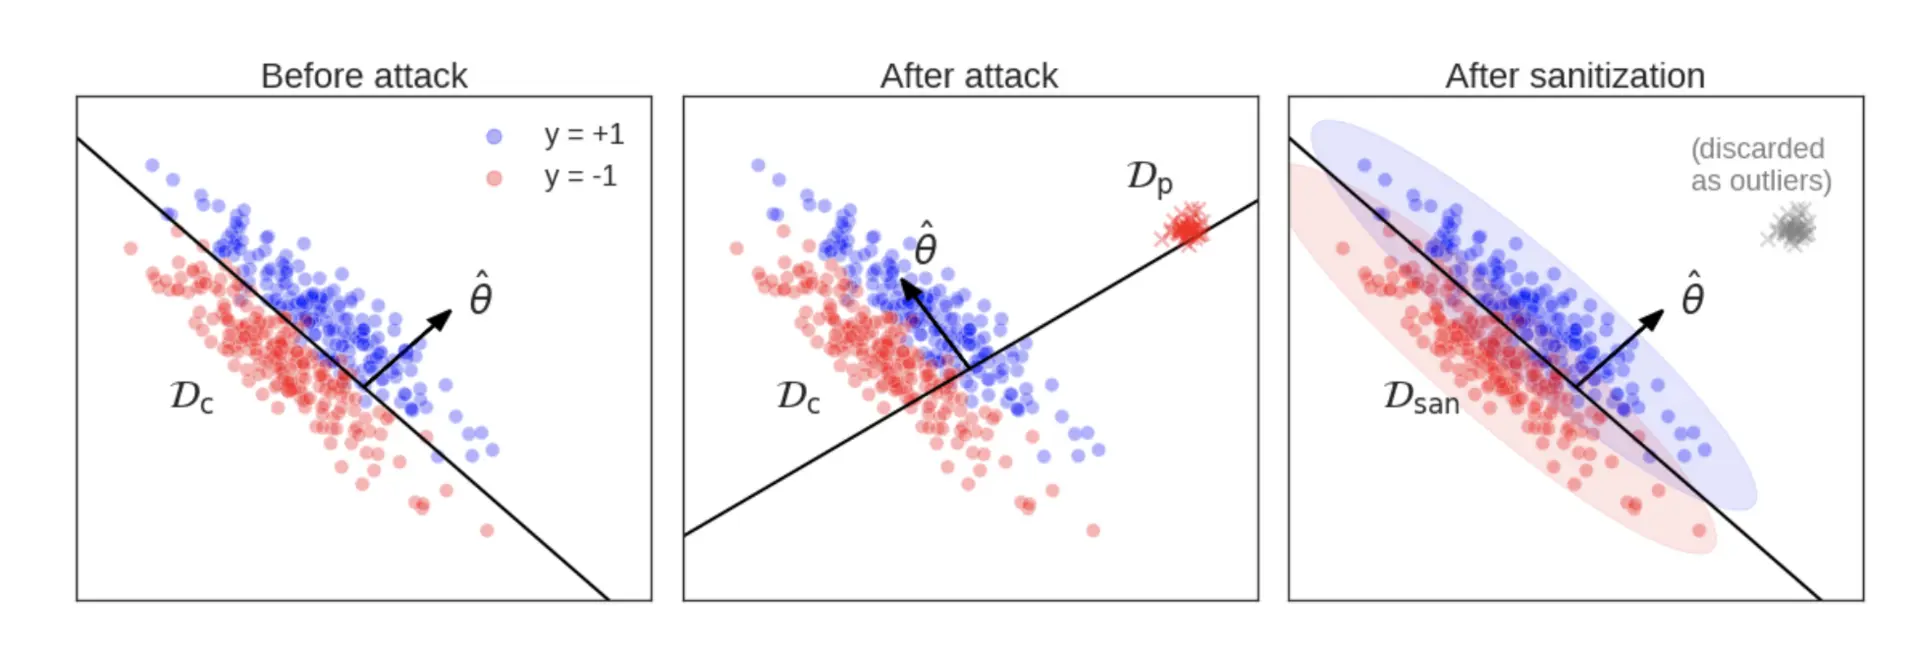
- تغییر توزیع دادهها: در این روش، توزیع دادههای آموزشی تغییر مییابد تا مدل نتواند به درستی به دادههای جدید generalize کند. به عنوان مثال، اگر در یک مدل پیشبینی قیمت مسکن، دادههای نادرستی از مناطق گرانقیمت به عنوان «ارزان» اضافه شود، مدل ممکن است در پیشبینی قیمتها دچار خطا شود.
اثرات مسمومسازی دادهها میتواند از کاهش دقت مدل تا بیاعتبار شدن کامل آن در کاربردهای حساس مانند تشخیص پزشکی یا سیستمهای امنیتی باشد.
چگونه میتوان از مسمومسازی دادهها جلوگیری کرد؟
برای مقابله با مسمومسازی دادهها، باید از روشهای مختلفی استفاده کرد. برخی از این روشها عبارتند از:
- تایید و تصحیح دادهها: قبل از استفاده از دادهها در آموزش مدل، باید دادهها را بررسی و تصحیح کرد. این کار میتواند شامل حذف دادههای نادرست، تصحیح برچسبها، و فیلتر کردن نویز باشد.
- استفاده از دادههای با کیفیت: استفاده از دادههای معتبر و از منابع قابل اعتماد میتواند خطر مسمومسازی دادهها را کاهش دهد.
- کنترل دسترسی: محدود کردن دسترسی به دادههای آموزشی و استفاده از سیستمهای مدیریت دسترسی میتواند از تغییرات غیرمجاز جلوگیری کند.
- استفاده از روشهای تشخیص آلودگی: استفاده از الگوریتمهای تشخیص آلودگی دادهها میتواند کمک کند تا دادههای نادرست شناسایی و حذف شوند.
- تکرار آموزش: آموزش مجدد مدل با دادههای جدید و تصحیح شده میتواند کمک کند تا اثرات مسمومسازی دادهها کاهش یابد.
همچنین، استفاده از روشهای پیشرفته مانند فیلتر کردن دادهها با استفاده از یادگیری عمیق یا استفاده از مدلهای ضد مسمومسازی میتواند در کاهش اثرات این تهدید مؤثر باشد.
مسمومسازی دادهها در دنیای واقعی
مسمومسازی دادهها در دنیای واقعی میتواند اثرات جدی داشته باشد. برای مثال، در سالهای اخیر گزارشهایی از مسمومسازی دادههای استفاده شده در مدلهای تشخیص چهره، سیستمهای خودران، و حتی مدلهای پیشبینی بازار مالی منتشر شده است. در برخی موارد، این کار باعث شده است که مدلها دچار اشتباهات جدی شوند و در کاربردهای حساس مانند تشخیص بیماریها یا تصمیمگیریهای مالی، به خطا بروند.
یکی از نمونههای معروف مسمومسازی دادهها، استفاده از دادههای نادرست در آموزش مدلهای تشخیص تصاویر است. در این موارد، مهاجم میتواند با تغییر برچسب تصاویر، مدل را به تشخیص اشتباه وادارد. برای مثال، در یک مدل تشخیص تصاویر پزشکی، اگر دادههای نادرستی از تومورهای غیرسرطانی به عنوان «سرطانی» اضافه شود، مدل ممکن است در تشخیص سرطان دچار اشتباه شود.
در دنیای هوش مصنوعی، امنیت دادهها به همان اندازه اهمیت دارد که خود دادهها. برای این منظور، باید از روشهای مختلفی برای محافظت از دادهها استفاده کرد و همواره در حال بهبود سیستمهای تشخیص آلودگی دادهها بود.
چگونه میتوان مدلهای هوش مصنوعی را در برابر مسمومسازی دادهها مقاوم کرد؟
برای افزایش مقاومت مدلهای هوش مصنوعی در برابر مسمومسازی دادهها، میتوان از روشهای زیر استفاده کرد:
- استفاده از دادههای متنوع: استفاده از دادههای متنوع از منابع مختلف میتواند کمک کند تا مدل در برابر دادههای نادرست مقاومتر باشد.
- تکرار آموزش با دادههای جدید: آموزش مجدد مدل با دادههای جدید و تصحیح شده میتواند اثرات مسمومسازی دادهها را کاهش دهد.
- استفاده از روشهای تشخیص آلودگی: استفاده از الگوریتمهای پیشرفته برای تشخیص دادههای آلوده میتواند کمک کند تا مدل در برابر مسمومسازی دادهها مقاومتر باشد.
- کنترل کیفیت دادهها: استفاده از سیستمهای کنترل کیفیت دادهها میتواند از آلودگی دادهها جلوگیری کند.
- استفاده از مدلهای ضد مسمومسازی: برخی از مدلهای هوش مصنوعی طراحی شدهاند تا در برابر مسمومسازی دادهها مقاوم باشند. استفاده از این مدلها میتواند کمک کند تا اثرات مسمومسازی دادهها کاهش یابد.
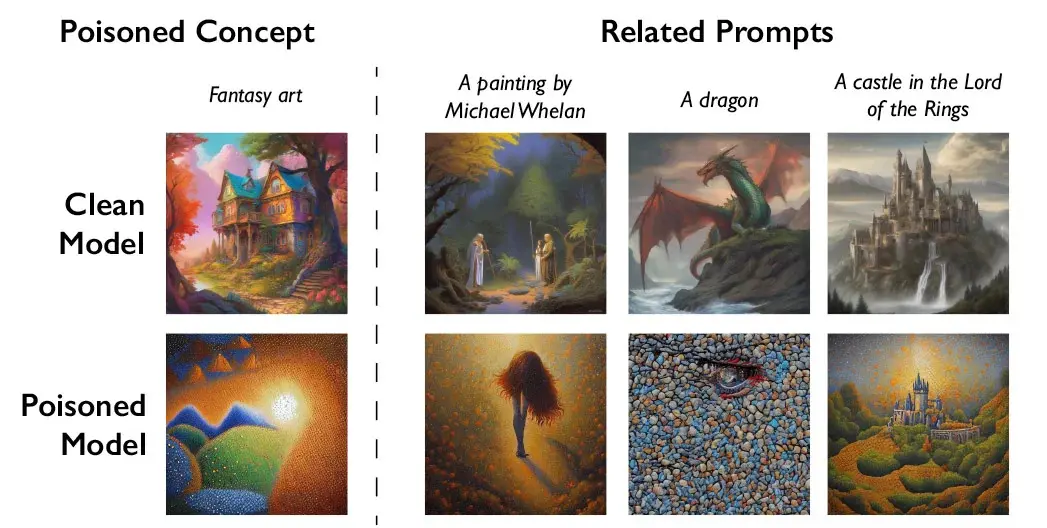
در نهایت، باید توجه داشت که مسمومسازی دادهها یک تهدید جدی است که میتواند اثرات جدی بر عملکرد مدلهای هوش مصنوعی داشته باشد. برای مقابله با این تهدید، باید از روشهای مختلفی استفاده کرد و همواره در حال بهبود سیستمهای تشخیص آلودگی دادهها بود.
برای اطلاعات بیشتر در مورد روشهای پیشرفته محافظت از دادهها و امنیت هوش مصنوعی، میتوانید به مقالات مرتبط در فناوری جهان مراجعه کنید. این منابع میتوانند راهنمایی ارزشمندی در زمینه بهبود امنیت دادهها و مدلهای هوش مصنوعی ارائه دهند.