داده برچسبگذاریشده چیست و چرا برای آموزش هوش مصنوعی اهمیت دارد؛ راهنمای کامل و کاربردی
در دنیای امروزی که هوش مصنوعی به یکی از مهمترین فناوریهای نوین تبدیل شده است، دادهها نقش اساسی در آموزش و بهبود مدلهای هوش مصنوعی دارند. اما دادههای خام به تنهایی کافی نیستند؛ برای اینکه مدلهای هوش مصنوعی بتوانند به درستی یاد بگیرند و تصمیمات هوشمندانه بگیرند، نیاز به دادههایی با کیفیت بالا و ساختارمند است. یکی از مفاهیم کلیدی در این زمینه، داده برچسبگذاریشده است. این نوع دادهها به مدلهای هوش مصنوعی کمک میکنند تا الگوها، روابط و معانی را در دادهها تشخیص دهند و به نتیجههای دقیقتری برسند.
داده برچسبگذاریشده چیست؟
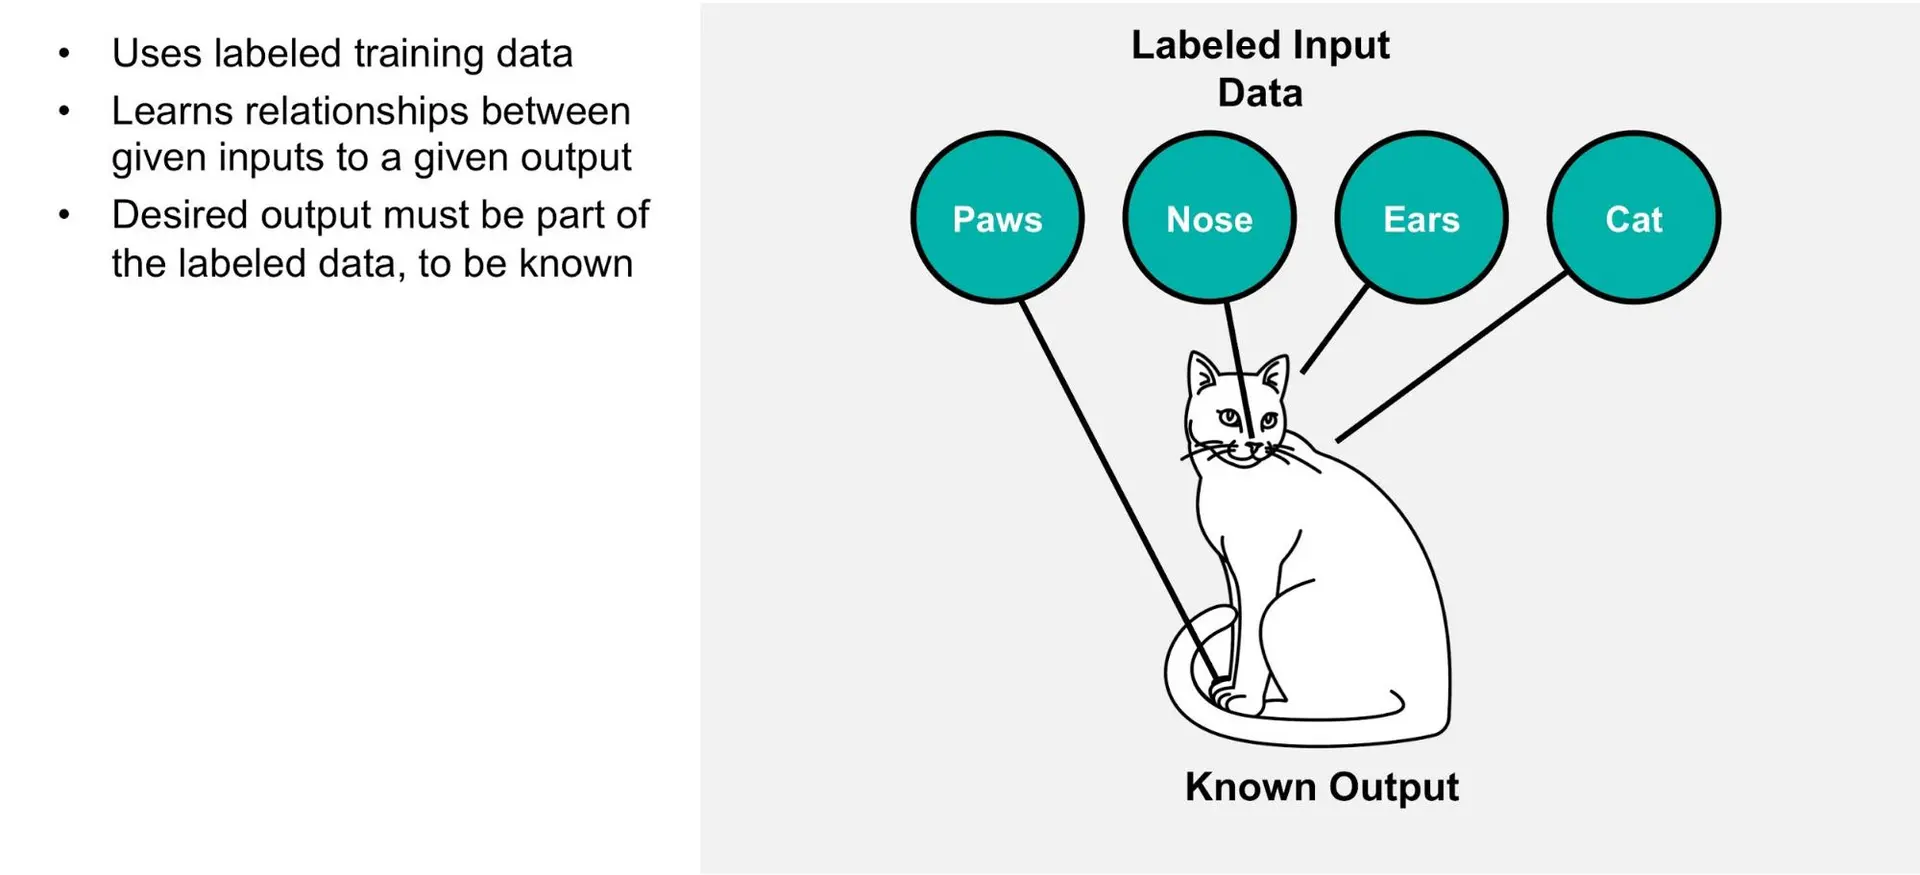
داده برچسبگذاریشده یا لبلزدن دادهها فرایندی است که در آن به دادههای خام، برچسبهایی اضافه میشود تا مدلهای هوش مصنوعی بتوانند آنها را درک و تحلیل کنند. این برچسبها میتوانند شامل دستهبندیها، توضیحات، یا حتی اطلاعات کمی باشند که به مدل کمک میکنند تا الگوها را شناسایی کند. برای مثال، در یک مجموعه داده از تصاویر، هر تصویر میتواند با برچسبی مانند “گربه”، “سگ”، یا “پارو” مشخص شود تا مدل یادگیری ماشین بتواند این تصاویر را به درستی طبقهبندی کند.
این فرآیند در واقع یک نوع انotation یا توضیحدهی به دادهها است که به مدلهای هوش مصنوعی کمک میکند تا از تجربههای قبلی خود استفاده کنند و بهتر یاد بگیرند. بدون این برچسبها، مدلها تنها میتوانند دادهها را به صورت خام تحلیل کنند و نمیتوانند معانی واقعی آنها را درک کنند.
چرا داده برچسبگذاریشده برای آموزش هوش مصنوعی اهمیت دارد؟
اهمیت داده برچسبگذاریشده در آموزش هوش مصنوعی از چند جهت قابل بررسی است:
- دقت بالاتر در پیشبینیها: مدلهای هوش مصنوعی با استفاده از دادههای برچسبگذاریشده میتوانند الگوها و روابط بین دادهها را بهتر تشخیص دهند و در نتیجه پیشبینیهای دقیقتری ارائه دهند.
- کاهش خطا: دادههای بدون برچسب ممکن است منجر به خطاهای زیادی در مدلهای یادگیری ماشین شوند. با برچسبگذاری دادهها، مدلها میتوانند از اشتباهات قبلی خود یاد بگیرند و عملکرد خود را بهبود بخشند.
- کارایی بیشتر: دادههای برچسبگذاریشده به مدلها کمک میکنند تا سریعتر و با کارایی بیشتری یاد بگیرند، زیرا اطلاعات لازم برای درک دادهها به صورت مستقیم در دسترس است.
- تخصصیتر شدن مدلها: در بسیاری از کاربردها، مانند تشخیص بیماریها در پزشکی یا ترجمه متنها در زبانشناسی، دادههای برچسبگذاریشده به مدلها اجازه میدهند تا به صورت تخصصیتر عمل کنند و نتایج بهتری ارائه دهند.
به عنوان مثال، در زمینه تشخیص تصویر، یک مدل هوش مصنوعی بدون دادههای برچسبگذاریشده نمیتواند تشخیص دهد که یک تصویر مربوط به چه موضوعی است. اما با برچسبگذاری تصاویر، مدل میتواند یاد بگیرد که چگونه تصاویر مختلف را از یکدیگر تشخیص دهد.
چگونه دادهها را برچسبگذاری میکنند؟
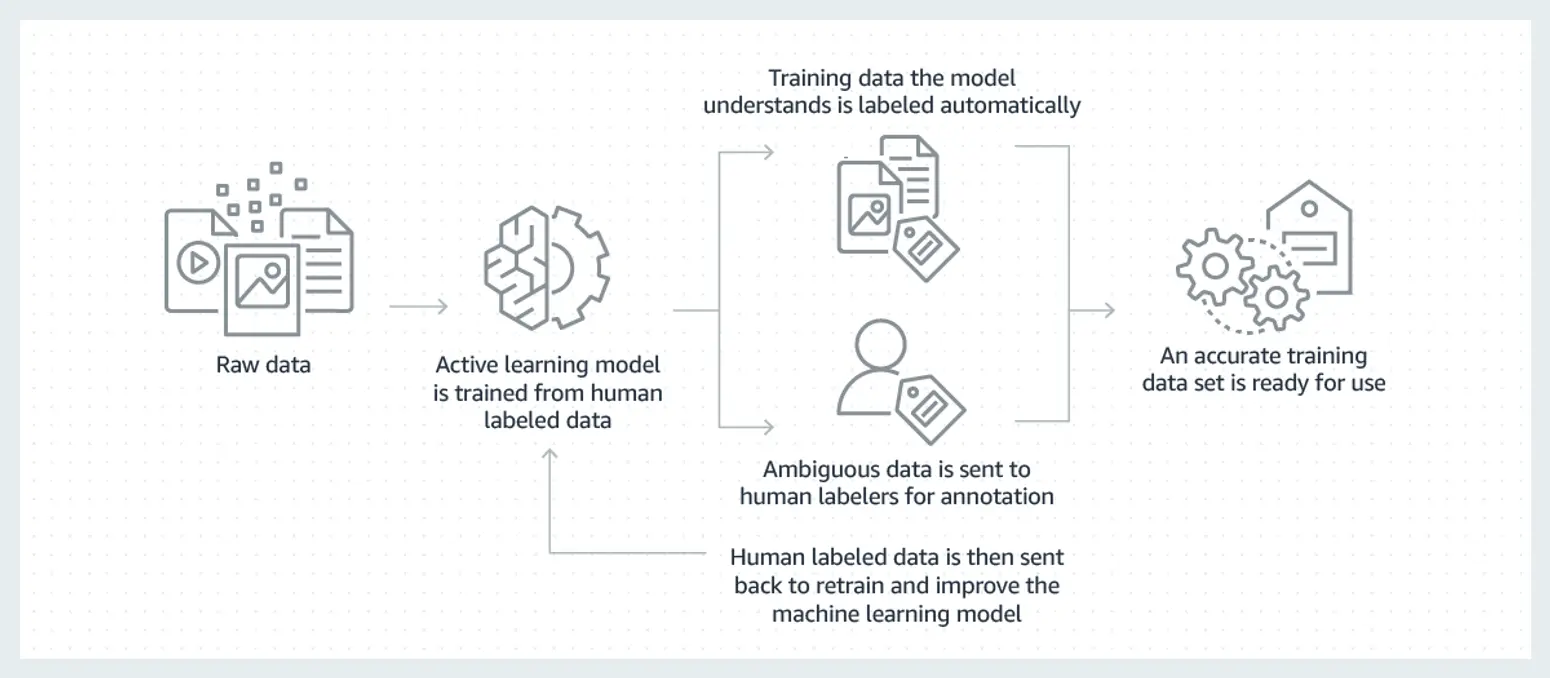
برچسبگذاری دادهها یک فرآیند پیچیده است که نیاز به دقت و تخصص دارد. این فرآیند میتواند به صورت دستی یا خودکار انجام شود، هرچند که در بسیاری از موارد، استفاده از روشهای دستی یا ترکیبی از دستی و خودکار رایجتر است.
برچسبگذاری دستی
در این روش، افراد متخصص دادهها را بررسی کرده و برچسبهای مناسب را به آنها اضافه میکنند. این روش دقیقتر است، اما زمانبر و گرانقیمت است. برای مثال، در پروژههای پزشکی یا حقوقی که نیاز به دقت بسیار بالا دارند، برچسبگذاری دستی معمولاً استفاده میشود.
برچسبگذاری خودکار
در این روش، از الگوریتمهای هوش مصنوعی یا ماشینلرنینگ برای برچسبگذاری دادهها استفاده میشود. این روش سریعتر و ارزانتر است، اما ممکن است دقت کمتری داشته باشد و نیاز به بررسی و تصحیح دستی داشته باشد. برای مثال، در پروژههای بزرگ داده که حجم دادهها بسیار زیاد است، از روشهای خودکار استفاده میشود.
برچسبگذاری ترکیبی
در بسیاری از موارد، ترکیبی از روشهای دستی و خودکار برای برچسبگذاری دادهها استفاده میشود. در این روش، ابتدا دادهها به صورت خودکار برچسبگذاری میشوند و سپس توسط افراد متخصص بررسی و تصحیح میشوند. این روش تعادل خوبی بین دقت و سرعت ایجاد میکند.
یکی از چالشهای اصلی در برچسبگذاری دادهها، اطمینان از کیفیت برچسبها است. دادههای با کیفیت پایین میتوانند منجر به مدلهای ضعیف و نتایج نادرست شوند. بنابراین، انتخاب روش مناسب برچسبگذاری و اطمینان از دقت آن بسیار مهم است.
کاربردهای داده برچسبگذاریشده در هوش مصنوعی
دادههای برچسبگذاریشده در بسیاری از حوزههای هوش مصنوعی کاربرد دارند. برخی از مهمترین کاربردها عبارتند از:
- پردازش زبان طبیعی (NLP): در این حوزه، دادههای برچسبگذاریشده مانند متنها با برچسبهای معنایی یا دستهبندیهای مختلف، به مدلهای زبان طبیعی کمک میکنند تا بهتر متنها را درک و تحلیل کنند.
- دیترکشن تصویر: در تشخیص تصاویر، دادههای برچسبگذاریشده مانند تصاویر با برچسبهای موضوعی، به مدلها کمک میکنند تا اشیاء و موضوعات مختلف را تشخیص دهند.
- پیشبینی و تحلیل داده: در حوزههای مانند پیشبینی بازار یا تحلیل رفتار مصرفکنندگان، دادههای برچسبگذاریشده به مدلها کمک میکنند تا الگوها و روندهای مهم را شناسایی کنند.
- رباتیک و خودران: در سیستمهای خودران یا رباتیک، دادههای برچسبگذاریشده مانند تصاویر با برچسبهای موقعیت یا حرکت، به سیستمها کمک میکنند تا بهتر عمل کنند.
به عنوان مثال، در پروژههای ترجمه خودکار، دادههای برچسبگذاریشده شامل جفتهای متن در زبانهای مختلف با ترجمههای دقیق هستند. این دادهها به مدلهای ترجمه کمک میکنند تا متنها را با دقت بیشتری ترجمه کنند.
چالشهای برچسبگذاری دادهها
برچسبگذاری دادهها با چالشهای متعددی همراه است که باید به آنها توجه کرد:
- زمانبر بودن: برچسبگذاری دستی دادهها زمانبر است و ممکن است برای پروژههای بزرگ غیرممکن باشد.
- هزینه: استخدام افراد متخصص برای برچسبگذاری دادهها هزینههای زیادی دارد.
- کیفیت: اطمینان از کیفیت برچسبها و جلوگیری از خطاهای انسانی یا الگوریتمی یکی از مهمترین چالشها است.
- مقیاسپذیری: در پروژههای بزرگ داده، مقیاسپذیری برچسبگذاری دادهها یک چالش بزرگ است.
برای حل این چالشها، بسیاری از شرکتها و سازمانها از روشهای خودکار یا ترکیبی استفاده میکنند و همچنین از ابزارهای تخصصی برای برچسبگذاری دادهها بهره میبرند.
نکات مهم در برچسبگذاری دادهها
برای اینکه دادههای برچسبگذاریشده به درستی و با کیفیت بالا تهیه شوند، باید به نکات زیر توجه کرد:
- دقت: اطمینان از دقت برچسبها بسیار مهم است. دادههای نادرست میتوانند منجر به مدلهای ضعیف شوند.
- همگن بودن: برچسبها باید به صورت یکنواخت و همگن باشد تا مدل بتواند الگوها را به درستی شناسایی کند.
- مقیاسپذیری: روش برچسبگذاری باید به گونهای باشد که بتواند با افزایش حجم دادهها مقیاسپذیر باشد.
- دسترسپذیری: دادههای برچسبگذاریشده باید به صورت سازمانیافته و قابل دسترسی برای مدلهای هوش مصنوعی در دسترس باشند.
همچنین، استفاده از ابزارهای مناسب برای برچسبگذاری دادهها میتواند فرآیند را سادهتر و کارآمدتر کند. بسیاری از شرکتها از نرمافزارهای تخصصی برای برچسبگذاری دادهها استفاده میکنند که میتوانند به افزایش دقت و کاهش زمان کمک کنند.
در پایان، باید توجه داشت که دادههای برچسبگذاریشده یکی از پایههای اصلی آموزش هوش مصنوعی هستند. بدون دادههای با کیفیت و ساختارمند، مدلهای هوش مصنوعی نمیتوانند به درستی یاد بگیرند و عملکرد خوبی داشته باشند. بنابراین، سرمایهگذاری در برچسبگذاری دادهها و اطمینان از کیفیت آنها یکی از مهمترین مراحل در توسعه سیستمهای هوش مصنوعی است.
برای اطلاعات بیشتر در مورد آخرین دستاوردهای هوش مصنوعی و روشهای بهبود دادهها، میتوانید به فناوری جهان مراجعه کنید و از مقالات تخصصی این حوزه بهرهمند شوید.