یادگیری تقویتی از بازخورد انسانی چیست و چرا برای مدلهای زبانی مهم است؛ قبل از اقدام این موارد را بدانید
در دنیای هوش مصنوعی و مدلهای زبانی، یادگیری تقویتی از بازخورد انسانی (Human Feedback Reinforcement Learning یا HFRL) به یکی از روشهای کلیدی برای بهبود عملکرد و دقت این سیستمها تبدیل شده است. این روش که ترکیبی از یادگیری تقویتی و تعامل با انسان است، به مدلها کمک میکند تا پاسخهای دقیقتر و متناسبتر با انتظارات کاربران ارائه دهند. اما قبل از اینکه به استفاده از این روش بپردازید، باید با اصول، مزایا، چالشها و مراحل اجرای آن آشنا شوید.
یادگیری تقویتی از بازخورد انسانی چیست؟
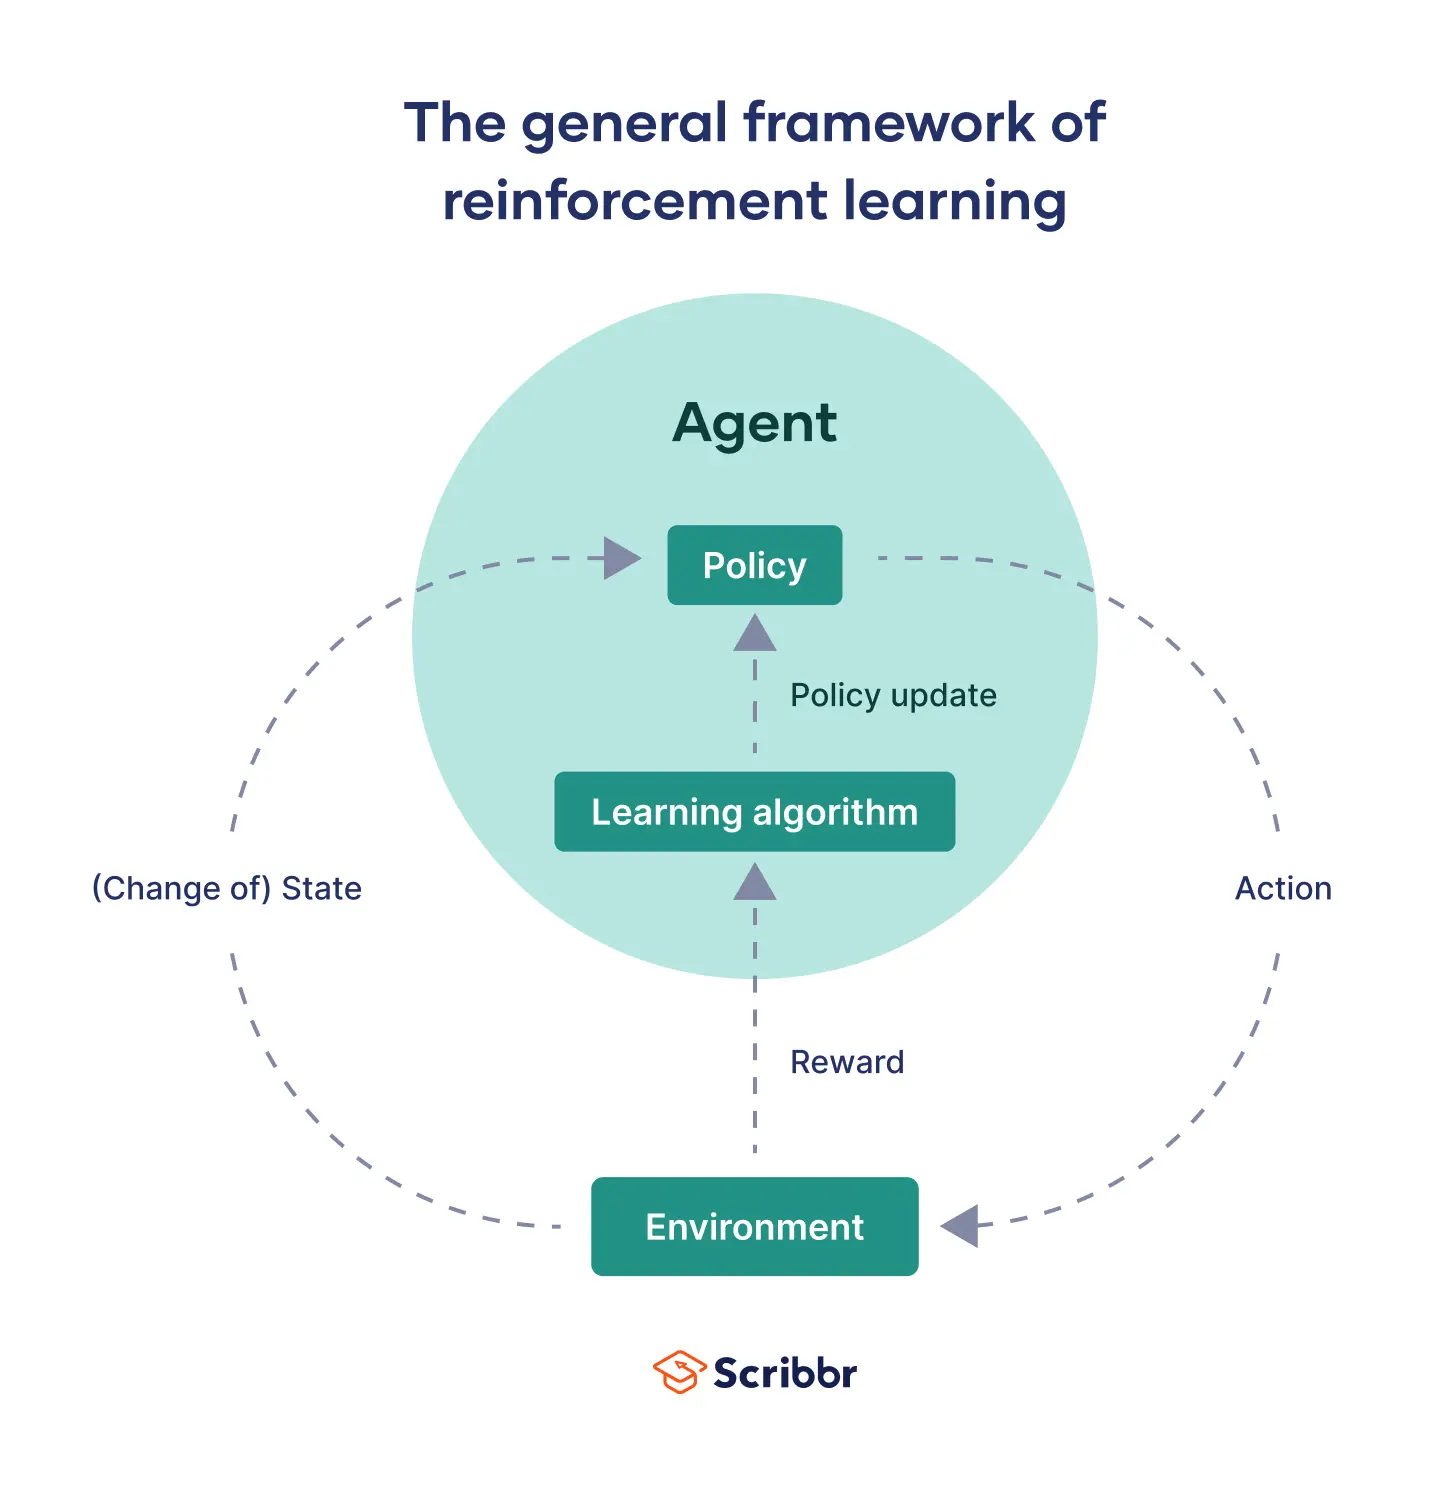
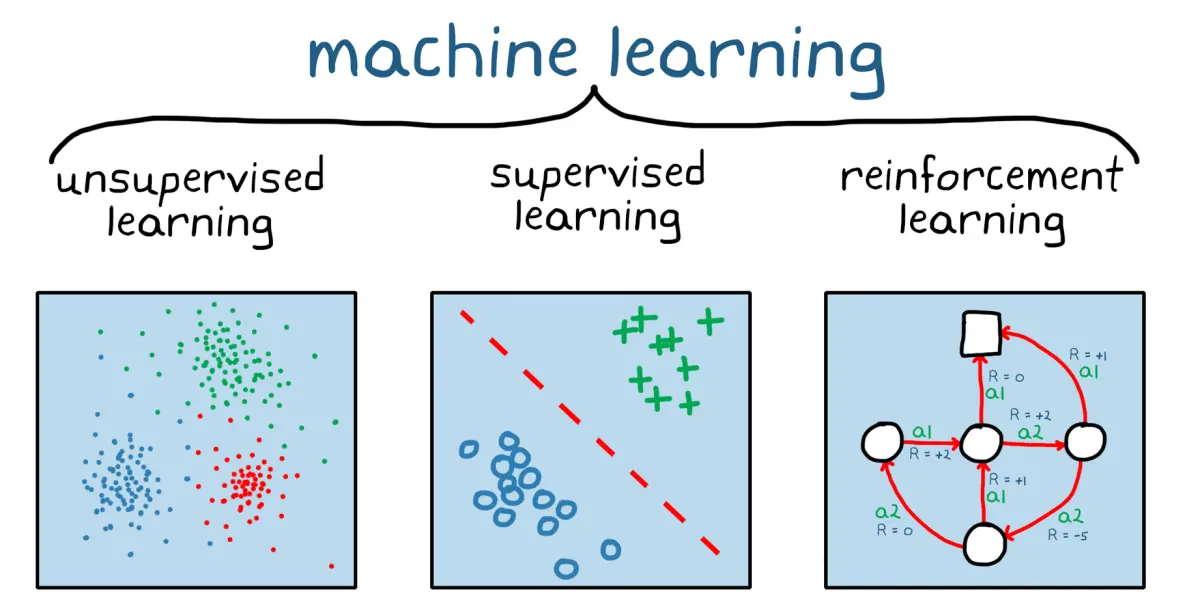
یادگیری تقویتی از بازخورد انسانی یک روش یادگیری ماشین است که در آن مدلهای هوش مصنوعی از بازخوردهای مستقیم انسان برای بهبود عملکرد خود استفاده میکنند. در این روش، یک مدل زبانی ابتدا با دادههای بزرگ آموزش میبیند، سپس با استفاده از بازخوردهای انسانی (مانند امتیازدهی یا اصلاحات دستی)، عملکرد خود را بهبود میبخشد. این بازخوردها میتوانند شامل انتخاب بهترین پاسخ از میان چندین گزینه، اصلاح متنهای تولید شده یا حتی امتیازدهی به کیفیت پاسخها باشند.
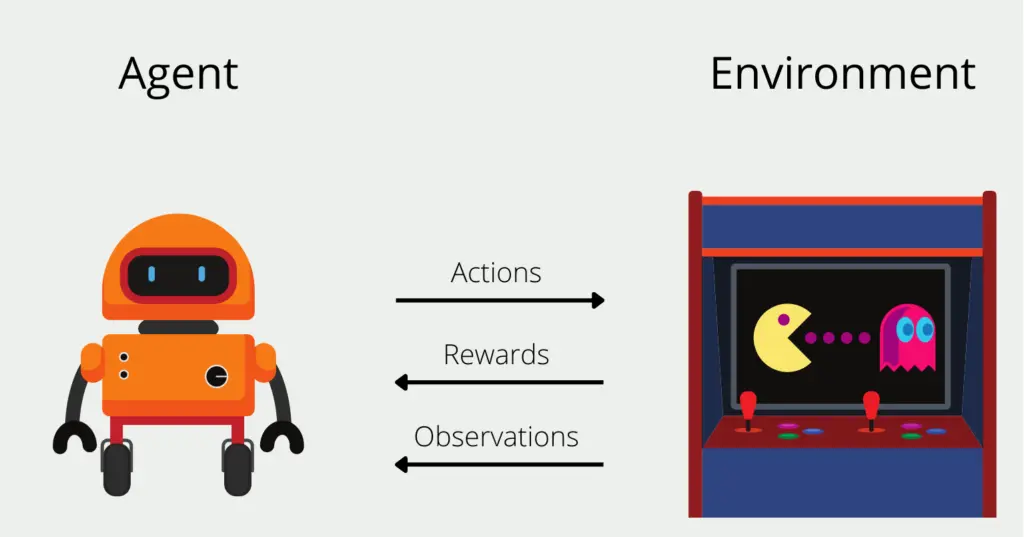
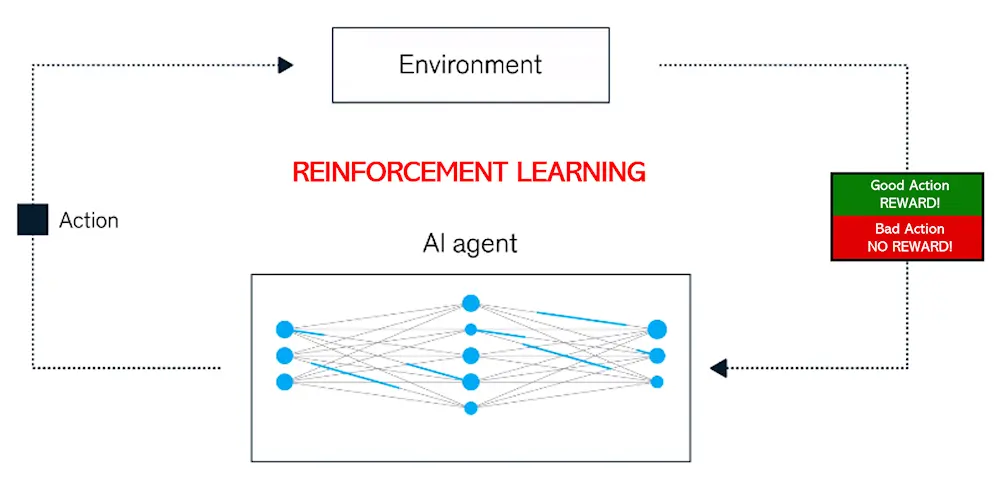
این روش بر اساس اصل تقویتی کار میکند: مدل از طریق دریافت بازخورد مثبت یا منفی، یاد میگیرد که چه پاسخهایی باید تقویت شوند و کدامها باید اصلاح یا حذف شوند. این فرآیند به مدل کمک میکند تا با زمان، پاسخهای دقیقتر و متناسبتر با نیازهای کاربر ارائه دهد.
چرا یادگیری تقویتی از بازخورد انسانی برای مدلهای زبانی مهم است؟
مدلهای زبانی امروزی مانند چتباتها و سیستمهای پاسخگویی خودکار، با حجم زیادی از دادهها آموزش میبینند، اما این دادهها همیشه دقیق یا متناسب با نیازهای کاربر نیستند. در اینجا یادگیری تقویتی از بازخورد انسانی وارد عمل میشود و مزایای زیر را ارائه میدهد:
- دقت بالاتر: با دریافت بازخورد مستقیم از انسان، مدلها میتوانند پاسخهای خود را با توجه به نیازهای واقعی کاربر اصلاح کنند.
- تناسب با فرهنگ و زبان: مدلها میتوانند با توجه به بازخوردهای فرهنگی و زبانی کاربران، پاسخهای خود را بهینه کنند.
- کاهش خطاهای غیرمنطقی: با استفاده از بازخورد انسانی، مدلها میتوانند پاسخهای غیرمنطقی یا نامناسب را شناسایی و اصلاح کنند.
- بهبود تجربه کاربر: پاسخهای دقیقتر و مناسبتر، تجربه کاربری را بهبود میبخشد و اعتماد کاربر به سیستم را افزایش میدهد.
این روش به ویژه در زمینههای حساس مانند پزشکی، حقوقی و خدمات مشتری، که دقت و صحت پاسخها بسیار مهم است، بسیار مؤثر است.
چالشهای یادگیری تقویتی از بازخورد انسانی
در حالی که یادگیری تقویتی از بازخورد انسانی مزایای بسیاری دارد، اجرای آن نیز با چالشهایی همراه است:
- هزینه و زمان: دریافت بازخورد انسانی نیاز به منابع انسانی زیادی دارد که این امر میتواند هزینهبر و زمانبر باشد.
- تنوع بازخورد: بازخوردهای انسانی ممکن است متنوع و گاهی حتی متضاد باشند، که میتواند باعث ایجاد نویز در دادهها شود.
- بیطرفی: اطمینان از این که بازخوردها بیطرف و بدون پیشداوری باشند، چالشبرانگیز است.
- مقیاسپذیری: با افزایش حجم دادهها و نیاز به بازخورد بیشتر، مقیاسپذیری سیستم میتواند مشکلساز شود.
برای مقابله با این چالشها، شرکتها و پژوهشگران به دنبال روشهای خودکارتر برای دریافت بازخورد و استفاده از الگوریتمهای پیشرفتهتر برای فیلتر کردن نویز هستند.
مراحل اجرای یادگیری تقویتی از بازخورد انسانی
برای اجرای موفق این روش، باید مراحل زیر را دنبال کرد:
- آموزش اولیه مدل: مدل زبانی با استفاده از دادههای بزرگ و روشهای یادگیری عمیق آموزش میبیند.
- دریافت بازخورد انسانی: کاربر یا یک تیم متخصص، پاسخهای مدل را بررسی و بازخورد میدهند. این بازخوردها میتوانند شامل امتیازدهی، انتخاب بهترین پاسخ یا اصلاح متن باشند.
- بهروزرسانی مدل: با استفاده از الگوریتمهای یادگیری تقویتی، مدل با توجه به بازخوردهای دریافتی، پارامترهای خود را بهروزرسانی میکند.
- تکرار و بهبود: این فرآیند به صورت تکراری انجام میشود تا مدل با زمان بهبود یابد.
در این فرآیند، انتخاب روش مناسب برای دریافت بازخورد و طراحی الگوریتمهای تقویتی بسیار مهم است. برای مثال، برخی از مدلها از روشهای خودکار مانند امتیازدهی خودکار یا استفاده از مدلهای پیشبینی کننده بازخورد استفاده میکنند.
کاربردهای عملی یادگیری تقویتی از بازخورد انسانی
این روش در زمینههای مختلفی مانند:
- چتباتها و دستیاران مجازی که نیاز به پاسخهای دقیق و انسانی دارند.
- سیستمهای پاسخگویی خودکار در خدمات مشتری که باید پاسخهای مناسب و مفید ارائه دهند.
- سیستمهای ترجمه خودکار که نیاز به دقت و تناسب فرهنگی دارند.
- سیستمهای تشخیص احساسات که باید پاسخهای مناسب با احساسات کاربر ارائه دهند.
کاربرد دارد. برای مثال، شرکتهای بزرگ مانند گوگل و مایکروسافت از این روش برای بهبود مدلهای زبانی خود استفاده میکنند.
نکات مهم قبل از اقدام به استفاده از این روش
اگر قصد استفاده از یادگیری تقویتی از بازخورد انسانی را دارید، باید به نکات زیر توجه کنید:
- انتخاب روش مناسب برای دریافت بازخورد: باید روشهای مناسب برای دریافت بازخورد انسانی طراحی کنید که بتواند نیازهای مدل را برآورده کند.
- اطمینان از کیفیت بازخورد: باید اطمینان حاصل کنید که بازخوردهای دریافتی دقیق، بیطرف و متناسب با نیازهای مدل باشند.
- مقیاسپذیری: سیستم باید بتواند با افزایش حجم دادهها و نیاز به بازخورد بیشتر، مقیاسپذیر باشد.
- ارزیابی مداوم: باید عملکرد مدل را به صورت مداوم ارزیابی و بهبود بخشید.
همچنین، میتوانید برای کسب اطلاعات بیشتر در مورد روشهای پیشرفتهتر در زمینه هوش مصنوعی و یادگیری ماشین، به مقالات و تحلیلهای ارائه شده در فناوری جهان مراجعه کنید.
در نهایت، یادگیری تقویتی از بازخورد انسانی یک روش قدرتمند برای بهبود مدلهای زبانی است، اما اجرای موفق آن نیاز به برنامهریزی دقیق، منابع کافی و استفاده از روشهای مناسب دارد. با توجه به مزایا و چالشهای این روش، میتوانید تصمیم بگیرید که آیا برای پروژههای خود مناسب است یا خیر.