تشخیص تقلب مالی با یادگیری ماشین چگونه انجام میشود؛ راهنمای کامل و کاربردی
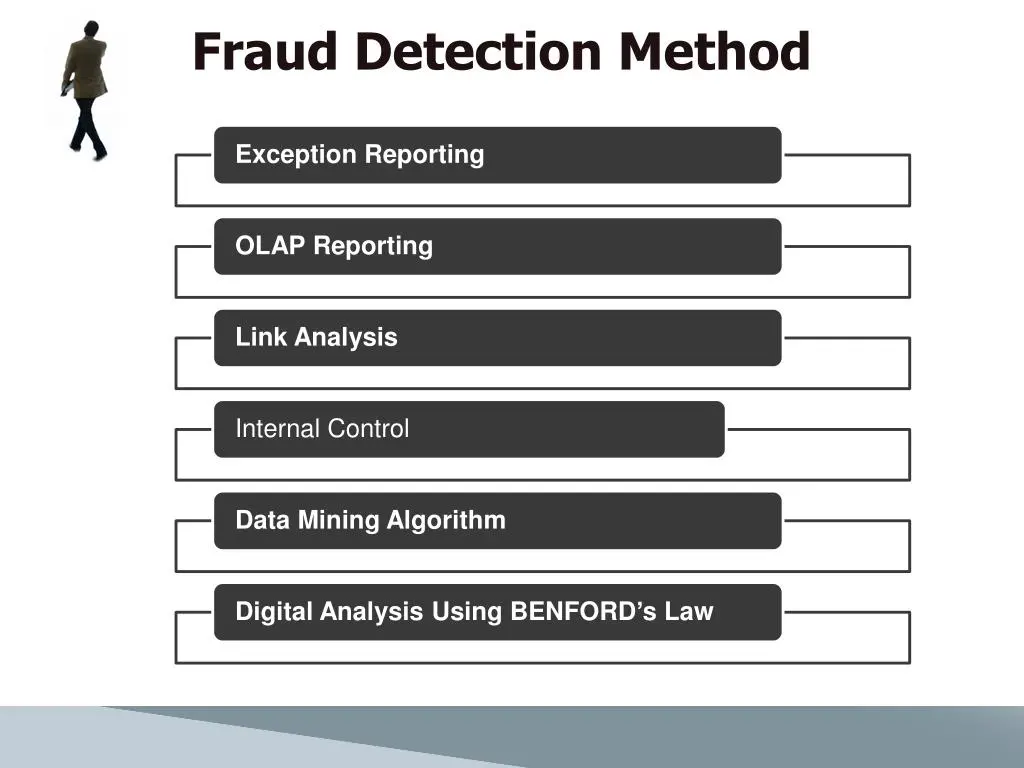
تقلب مالی یکی از بزرگترین چالشهای سازمانها، شرکتها و حتی دولتها در دنیای امروزی است. با پیشرفت فناوری و افزایش حجم دادهها، تشخیص تقلب به یک نیاز حیاتی تبدیل شده که بدون استفاده از روشهای هوشمند و خودکار، امکانپذیر نیست. در این راهنما، به بررسی روشهای تشخیص تقلب مالی با استفاده از یادگیری ماشین میپردازیم و نشان میدهیم که چگونه این فناوری میتواند به سازمانها کمک کند تا فعالیتهای مشکوک را شناسایی و از زیانهای مالی جلوگیری کنند.
چرا تشخیص تقلب مالی اهمیت دارد؟
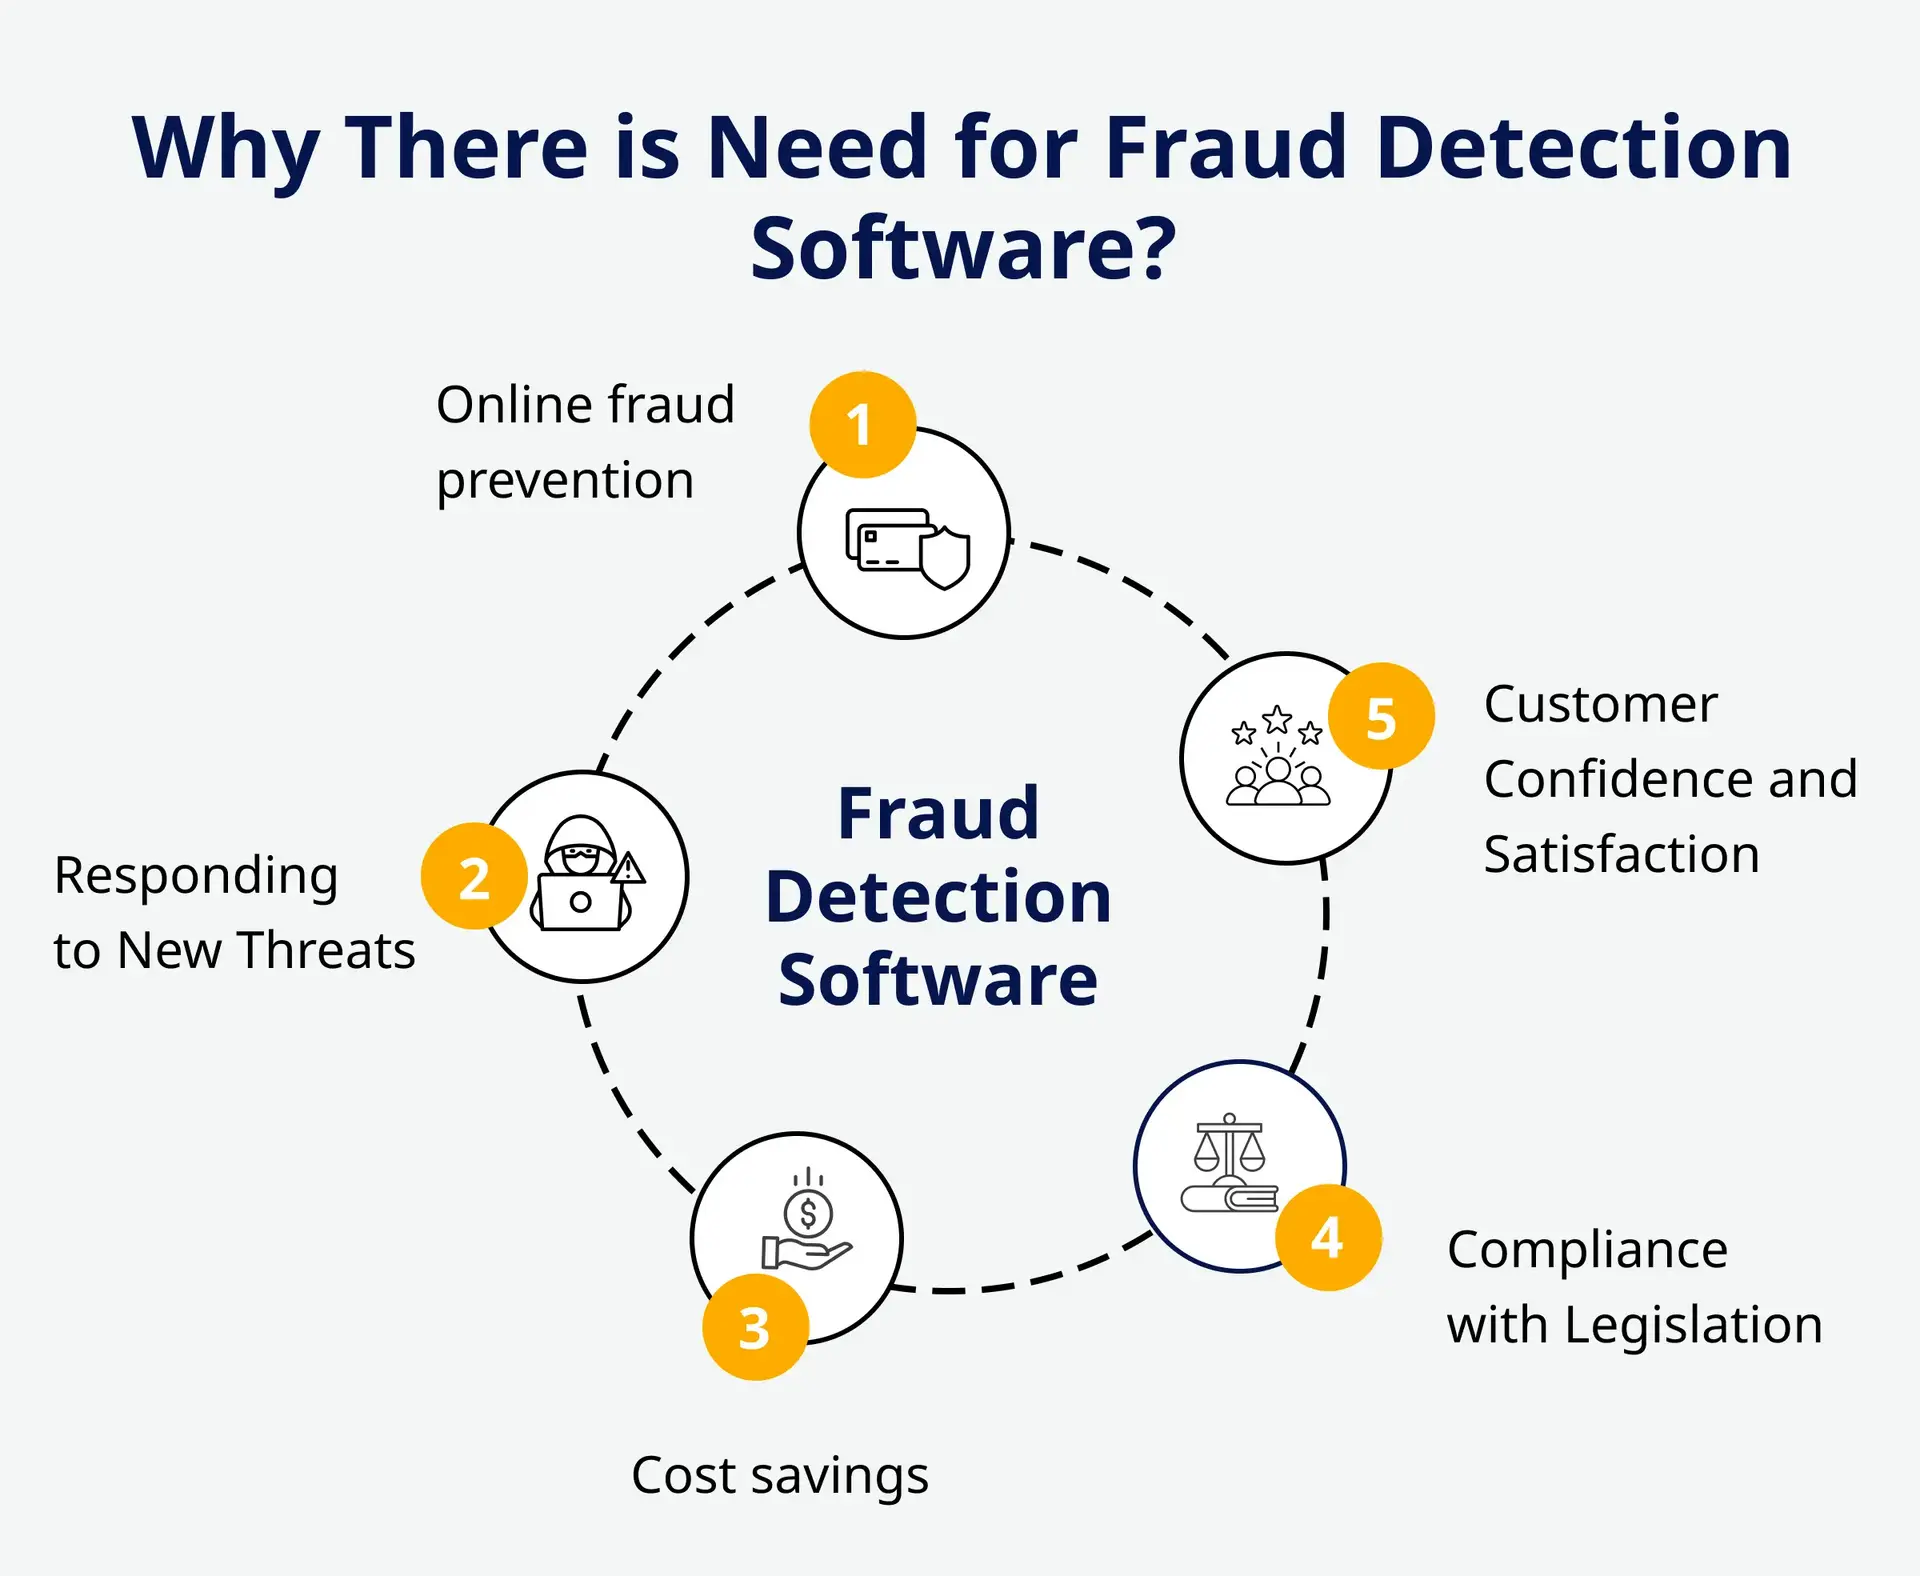
تقلب مالی میتواند شامل انواع مختلفی از فعالیتهای غیرقانونی باشد، از جمله دزدی اطلاعات، جعل اسناد، سوءاستفاده از منابع مالی و حتی کلاهبرداری در معاملات تجاری. این فعالیتها نه تنها به سازمانها زیان مالی وارد میکنند، بلکه میتوانند به آسیب به شهرت و اعتماد عمومی نیز منجر شوند. بر اساس گزارشهای بینالمللی، بسیاری از شرکتها و موسسات مالی سالانه میلیونها دلار به دلیل تقلب از دست میدهند. بنابراین، استفاده از روشهای پیشرفته برای تشخیص این فعالیتها ضروری است.
یادگیری ماشین به عنوان یکی از زیرشاخههای هوش مصنوعی، توانایی تحلیل دادههای بزرگ و شناسایی الگوهای پنهان را دارد. این فناوری میتواند با استفاده از الگوریتمهای مختلف، رفتارهای غیرعادی را شناسایی و هشدار دهد. در ادامه، به بررسی مراحل اصلی تشخیص تقلب مالی با یادگیری ماشین میپردازیم.
مراحل تشخیص تقلب مالی با یادگیری ماشین
۱. جمعآوری و آمادهسازی دادهها
اولین مرحله در تشخیص تقلب مالی، جمعآوری دادههای مرتبط است. این دادهها میتوانند شامل تراکنشهای مالی، اطلاعات مشتریان، تاریخچه فعالیتهای آنلاین و حتی دادههای شبکه اجتماعی باشند. اما جمعآوری داده تنها بخشی از کار است؛ آمادهسازی دادهها برای مدل یادگیری ماشین نیز بسیار مهم است.
در این مرحله، دادهها باید تمیز و ساختاردهی شوند. این شامل حذف دادههای ناقص یا تکراری، استانداردسازی فرمتها و تبدیل دادهها به یک قالب قابل تحلیل میشود. همچنین، ویژگیهای مهم برای تشخیص تقلب باید شناسایی و استخراج شوند. برای مثال، در تراکنشهای مالی، ویژگیهایی مانند زمان، مبلغ، مکان و حتی رفتار کاربر میتوانند نشانههایی از فعالیتهای مشکوک باشند.
۲. انتخاب الگوریتم مناسب
پس از آمادهسازی دادهها، مرحله بعدی انتخاب الگوریتم مناسب برای تشخیص تقلب است. یادگیری ماشین دارای انواع مختلفی از الگوریتمها است که هر کدام برای شرایط خاصی مناسب هستند. برخی از الگوریتمهای رایج در تشخیص تقلب مالی عبارتند از:
- الگوریتمهای مبتنی بر درخت تصمیم (Decision Trees): این الگوریتمها میتوانند با تقسیم دادهها به گروههای مختلف، الگوهای تقلب را شناسایی کنند. درختهای تصمیم به دلیل تفسیرپذیری بالا و سرعت تحلیل، در بسیاری از سیستمهای تشخیص تقلب استفاده میشوند.
- شبکههای عصبی (Neural Networks): شبکههای عصبی عمیق (Deep Learning) توانایی تحلیل دادههای پیچیده و شناسایی الگوهای پنهان را دارند. این الگوریتمها برای دادههای بزرگ و پیچیده بسیار مؤثر هستند، اما نیاز به منابع محاسباتی زیادی دارند.
- الگوریتمهای خوشهبندی (Clustering): این الگوریتمها مانند K-Means میتوانند دادهها را به گروههای مشابه تقسیم کنند و رفتارهای غیرعادی را شناسایی کنند. خوشهبندی به ویژه در تشخیص تقلبهای پیچیده و پنهان بسیار مفید است.
- ماشین بردار پشتیبانی (Support Vector Machines – SVM): این الگوریتم برای دادههای با ابعاد بالا و تشخیص الگوهای غیرخطی مناسب است و در بسیاری از سیستمهای تشخیص تقلب استفاده میشود.
- الگوریتمهای مبتنی بر یادگیری عمیق (Deep Learning): مانند خودکارهای شبکه عصبی (Autoencoders) که میتوانند دادههای مالی را تحلیل کرده و فعالیتهای مشکوک را شناسایی کنند.
انتخاب الگوریتم مناسب بستگی به نوع دادهها، حجم آنها و همچنین نیازهای سازمان دارد. برای مثال، اگر دادهها بسیار بزرگ و پیچیده باشند، استفاده از شبکههای عصبی عمیق ممکن است بهترین انتخاب باشد، در حالی که برای دادههای سادهتر، الگوریتمهای مبتنی بر درخت تصمیم یا SVM میتوانند کارآمدتر باشند.
۳. آموزش مدل یادگیری ماشین
پس از انتخاب الگوریتم، مرحله آموزش مدل آغاز میشود. در این مرحله، مدل با استفاده از دادههای تاریخی که شامل نمونههای تقلب و غیرتقلب هستند، آموزش میبیند. دادههای آموزشی باید شامل نمونههای مختلفی از فعالیتهای مالی باشند تا مدل بتواند الگوهای مختلف را تشخیص دهد.
در این مرحله، پارامترهای مدل تنظیم میشوند تا دقت آن به حداکثر برسد. این شامل تنظیم پارامترهای الگوریتم، انتخاب ویژگیهای مهم و حتی استفاده از تکنیکهای افزایش داده (Data Augmentation) برای بهبود عملکرد مدل است. همچنین، تقسیم دادهها به مجموعههای آموزشی، تست و اعتبار سنجی (Train, Test, Validation) ضروری است تا عملکرد مدل در شرایط واقعی ارزیابی شود.
۴. ارزیابی و بهبود مدل
پس از آموزش مدل، مرحله ارزیابی آغاز میشود. در این مرحله، مدل با دادههای تستی که قبلاً برای آموزش استفاده نشدهاند، آزمایش میشود. معیارهای مختلفی مانند دقت (Accuracy)، حساسیت (Sensitivity)، خاصیت (Specificity) و F1 Score برای ارزیابی عملکرد مدل استفاده میشوند.
اگر مدل عملکرد خوبی نداشته باشد، ممکن است نیاز به بهبود داشته باشد. این بهبودها میتوانند شامل:
- افزایش حجم دادههای آموزشی
- تغییر الگوریتم یا پارامترهای آن
- استفاده از تکنیکهای پیشپردازش داده بهتر
- افزایش قدرت محاسباتی برای مدلهای پیچیدهتر
همچنین، مدل باید بهطور مداوم با دادههای جدید آموزش داده شود تا بتواند با تغییرات جدید در رفتارهای تقلب سازگار شود.
۵. پیادهسازی و نظارت بر مدل
پس از ارزیابی و بهبود مدل، مرحله پیادهسازی آغاز میشود. مدل باید در سیستمهای موجود سازمان ادغام شود تا بتواند در زمان واقعی فعالیتهای مشکوک را شناسایی کند. این ممکن است شامل ادغام با سیستمهای پرداخت، بانکداری الکترونیک یا حتی نرمافزارهای حسابداری باشد.
نظارت بر مدل نیز بسیار مهم است. مدل باید بهطور مداوم بررسی شود تا از عملکرد صحیح آن اطمینان حاصل شود. همچنین، با تغییرات جدید در روشهای تقلب، مدل باید بهروزرسانی شود تا همچنان مؤثر باشد.
چالشهای تشخیص تقلب مالی با یادگیری ماشین
در حالی که استفاده از یادگیری ماشین در تشخیص تقلب مالی بسیار مؤثر است، اما با چالشهایی نیز همراه است:
- دادههای ناکافی یا ناهمگن: در بسیاری از موارد، دادههای مربوط به تقلب بسیار محدود هستند و این میتواند باعث کاهش دقت مدل شود.
- تغییرات مداوم در روشهای تقلب: تقلبکنندگان نیز با استفاده از فناوریهای جدید، روشهای خود را تغییر میدهند و این میتواند باعث شود که مدلهای قدیمی دیگر مؤثر نباشند.
- مشکلات مربوط به خصوصیت دادهها: دادههای مالی اغلب حاوی اطلاعات حساس هستند و باید با رعایت قوانین خصوصیت دادهها (مانند GDPR) پردازش شوند.
- نیاز به منابع محاسباتی: برخی از الگوریتمهای پیشرفته مانند شبکههای عصبی عمیق نیاز به منابع محاسباتی زیادی دارند که برای برخی سازمانها ممکن است هزینهبر باشد.
با این حال، با استفاده از روشهای مناسب و بهروزرسانی مداوم مدلها، میتوان این چالشها را کاهش داد و از کارایی سیستم تشخیص تقلب افزایش داد.
نکات کاربردی برای سازمانها
اگر شما نیز قصد استفاده از یادگیری ماشین برای تشخیص تقلب مالی را دارید، نکات زیر میتوانند به شما کمک کنند:
- استفاده از دادههای تاریخی: هرچه حجم دادههای تاریخی بیشتر باشد، مدل بهتر آموزش میبیند و دقت بیشتری خواهد داشت.
- تغییر مداوم الگوریتمها: با تغییر روشهای تقلب، الگوریتمهای استفاده شده نیز باید بهروزرسانی شوند.
- نظارت بر فعالیتهای مشکوک: حتی اگر مدل یک فعالیت را مشکوک تشخیص دهد، باید توسط کارشناسان بررسی شود تا از اشتباهات کاذب جلوگیری شود.
- استفاده از ترکیبی از روشها: استفاده از چندین الگوریتم مختلف میتواند دقت سیستم را افزایش دهد.
- رعایت قوانین خصوصیت داده: در پردازش دادههای مالی، باید به قوانین مربوط به خصوصیت دادهها توجه کرد.
در نهایت، تشخیص تقلب مالی با یادگیری ماشین یک فرآیند پیچیده اما بسیار مؤثر است. با استفاده از روشهای مناسب و بهروزرسانی مداوم، سازمانها میتوانند از زیانهای مالی جلوگیری کرده و امنیت مالی خود را افزایش دهند.
برای اطلاعات بیشتر در مورد کاربردهای هوش مصنوعی در حوزههای مختلف، میتوانید به فناوری جهان مراجعه کنید.